تحلیل رگرسیون: موتور حرکت اقتصاد تجربی(قسمت دوم-ادامه از خبر قبلی)
جعفر خیرخواهان
توماس مایر<br>مترجم: جعفر خیرخواهان<br>حدس نادرست که کدام متغیر کنترل را بگنجانیم نیز خطرناک است. حتی وقتی فقط در بین متغیرهای کنترل ظاهرا معقول انتخاب میکنیم، اندازه ضریبی که به آن علاقهمند هستید رابطه قوی با متغیر کنترلی پیدا میکند که در رگرسیون گنجانیدهاید.
توماس مایر
مترجم: جعفر خیرخواهان
حدس نادرست که کدام متغیر کنترل را بگنجانیم نیز خطرناک است. حتی وقتی فقط در بین متغیرهای کنترل ظاهرا معقول انتخاب میکنیم، اندازه ضریبی که به آن علاقهمند هستید رابطه قوی با متغیر کنترلی پیدا میکند که در رگرسیون گنجانیدهاید.
برخی اوقات وقتی متغیرهای متفاوتی را شامل میکنید حتی علامت ضریب تغییر میکند. یک مثال کلاسیک این پرسش است که آیا مجازات مرگ جلوی قتل را میگیرد. بیشتر مطالعات نرخ خودکشی در ایالتهای مختلف را روی یک متغیر ساختگی رگرس کردهاند که آیا آن ایالت مجازات اعدام را در کنار چندین متغیر کنترل وضع کند یا خیر. نتایج آنها یکسره تغییر میکند از این حالت که مجازات اعدام عامل بازدارنده قوی خودکشی است تا این حالت که هیچ اثری ندارد یا حتی اثر مثبت بر نرخ خودکشی دارد.
هنگام استفاده از دادههای سری زمانی، خیلی آسان میتوان به خاطر متغیر کنترل مفقودی به اشتباه افتاد. در بیشتر سریهای زمانی مثل جمعیت هند، تولید ملی بلژیک و تعداد بازدیدکنندگان از گالری اوفیزی در فلورانس و ... یک روند به سمت بالا داریم؛ بنابراین همبستگی وجود دارد. خوشبختانه، رگرس کردن تغییرات سال به سال، به جای استفاده از سطح متغیرها، اغلب کافی است تا این روند زمانی مشترک را حذف کند.
در حالی که همه اینها قطعا مسالهساز هستند، به این معنی نیست که باید خود را به دامن ناامیدی پستمدرنیسم بیندازیم و اعلان کنیم به همان اندازه که مجازات اعدام مانع قتل میشود، «درست» است به همان اندازه هم نادرست است یا خودمانیم لکلکها همراه خود نوزاد میآورند و نمیآورند، اما به این معنی هست که باید نگران این باشیم که کدام متغیر کنترل را شامل کنیم و کدامیک را شامل نکنیم. یک روال کار مفید این است که سعی کنیم چندین مجموعه رگرسیونها را امتحان کنیم که شامل متغیرهای کنترل متفاوت میشود تا ببینیم نتایج ما با توجه به برخی انتخابهای تقریبا دلبخواه متغیرهای کنترل چقدر استحکام دارد. فقط در صورتی که تمام این «آزمونهای استحکام» نتایج مشابهی در کل به دست دهد، میتوانیم درباره نتایج احساس اطمینان کنیم.
پل زهوار دررفته (مغالطه) علت شمردن امر مقدم
اگر نوشتن و تلفظ «همبستگی» به «همرابطهای» تغییر یابد بسیاری از سردرگمیها برطرف میشود. با این تغییر در نوشتن میخواهیم روشن سازیم که همبستگی به این معنی است که دو یا چند متغیر یک رابطه خاص با هم دارند از این قبیل که Y همیشه بالا است وقتی که X بالا باشد. بیشتر فیلسوفان (و فیلسوفان، نگهبانان مفهوم علیت مدنظر ما هستند) و اقتصاددانان (که به علیت بسیار علیتر از فیلسوفان فکر میکنند) توافق دارند که چیزی بیش از چنین همرابطهای نیاز است تا ثبات شود که x و y رابطه علّی با هم دارند. تعیین اینکه دقیقا به چه چیزی نیاز است، یک مساله فلسفی عمیق و فوقالعاده دشوار است. بگذارید از این مبحث رد شویم و در عوض استفاده روزمره این اصطلاح با همه ابهام و گنگ بودن آن را بکار ببریم. این مفهوم گنگ کافی است، زیرا همه آن کاری که میخواهم انجام دهم تقویت توانایی شما برای ایستادگی در برابر ادعاهایی است که صرفا با نشان دادن اینکه همبستگی وجود دارد ثابت میکنند یک رابطه علّی داریم.
اگر دادهها نشان میدهد که x و y همبستگی دارند میتواند به دلایل زیر باشد: (۱) x واقعا باعث y میشود همان طور که ادعا شده است؛ (۲) همزمانی داریم یا به بیان دیگر، نمونه خیلی کوچک است؛ (۳) کوتاهی در گنجاندن متغیرهای کنترلی درست؛ و (۴) y باعث x میشود یا به اصطلاح «علیت معکوس» داریم. حالت نخست که x واقعا علت y است که ادعا هم میشود مشکلی ایجاد نمیکند و بنابراین نیازی به بحث ندارد. حالت دوم را که همزمانی است، میتوان بهسرعت برطرف کرد با اشاره به اینکه اگر از سطح ۵ درصد معنیدار بودن استفاده کنیم و اگر دادهها توزیع نرمال داشته باشند پس در حداکثر ۵ درصد موارد باید انتظار داشت که یک رابطه معنیدار آماری- اما ساختگی- بین x و y پیدا کنیم. من در مطالب بالا به حالت سوم که غیبت متغیرهای کنترل درست است پرداختم؛ اگر z باعث هم x و y میشود، پس رگرس کردن y صرفا روی x منجر به همبستگی ساختگی میشود.
حالت چهارم، علیت معکوس، یک مشکل همه جا حاضر است. بارها و بارها رسانهها گزارشهایی از این قبیل را منتشر میکنند که افرادی که ورزش میکنند تندرستتر هستند، ابدا تعجبی ندارد: شاید نشان میدهد که ورزش مردم را تندرست نگه میدارد یا اینکه بیشتر افراد بیمار نمیتوانند ورزش کنند.
مردان متاهل درآمد بیشتری نسبت به مردان مجرد دارند، پس ازدواج کردن شما را ثروتمندتر میکند. بله به نظر قابل تامل میآید، اما این نکته نیز قابل تامل است که زنان، کمتر احتمال دارد با مردانی ازدواج کنند که درآمد پایینی دارند. کشورهایی که حمایت قوی از حقوق مالیکت میکنند درآمد سرانه بالاتری نسبت به کشورهایی دارند که چنین کاری نمیکنند. آیا نتیجه میگیریم کشورهایی که حقوق مالکیت ضعیف دارند میتوانند با تقویت این حقوق، درآمدهایشان را افزایش دهند یا اینکه نتیجه میگیریم ثروتمند شدن یک کشور را وادار میکند تا از حقوق مالکیت حمایت کند؟ یا اینکه احتمالا یک کمی از هر دو درست است؟ اگر نامزدی که کمکهای انتخاباتی بیشتری دریافت میکند معمولا برنده انتخابات میشود، آیا منظور این است که کمکهای انتخاباتی نتیجه انتخابات را تعیین میکند یا اینکه نامزدهایی که احتمال بیشتری برای برنده شدن دارند کمکهای انتخاباتی بیشتری دریافت میکنند؟ دادهها نشان میدهد که افراد خوشبین خوشحالتر هستند. آیا منظور این است که باورهای خوشبینانه باعث میشود مردم خوشحال شوند یا اینکه خوشحال بودن باعث میشود تا شما بیشتر در معرض این باور باشید که
همه چیز خوب است؟ آیا قاعده طلایی، یعنی آن کس که طلا دارد قاعدهها را تعیین میکند یا آن کسی که قاعدهها را تعیین میکند طلاها را به دست میآورد؟ هر وقت با یک همبستگی گزارش شده برخورد کردید باید چنین پرسشی را همیشه بپرسید:«اگر علیتی وجود دارد کدام علت و کدام معلول است؟»
چگونه میتوان گفت که آیا یک همبستگی پیام معتبر علیت را با خود حمل میکند؟ در مواردی که خودمان در بهوجود آوردن تغییرات در یکی از متغیرها دخالت داشتهایم کار آسان است، برای مثال با گرم کردن یک ماده شیمیایی میبینیم آیا آن ماده منفجر خواهد شد و یکی از دلایل مهم که روش آزمایشگاهی، علوم طبیعی را اینقدر کارآمد ساخته است همین است. در شرایطی که خودمان کاری نکردیم نیز میدانیم کدام علت و کدام معلول است، وقتی دخالت توسط عاملی صورت میگیرد که نمیتواند نتیجه متغیری باشد که ما متغیر وابسته در نظر گرفتیم. سقف فرو میریزد چون توفان آمده است: فروریختن سقف باعث توفان نشده است. در علم اقتصاد چنین دخالتهای آشکارا برونزا، اگر چه کاملا غایب نیستند نادر هستند، اما هر جا که بتوان آنها را پیدا کرد قادر به حل علیت معکوس، بسیار بهتر از هر روش دیگری هستیم. برای مثال، همبستگی روشنی بین تعداد سالهای تحصیل و تندرستی وجود دارد، اما میتواند به این خاطر باشد که تحصیلات مردم را وا میدارد تا سبک زندگی سالمتری برگزینند یا اینکه دانشآموزان تندرست مدت زمان طولانی نسبت به دانشآموزان بیمار در مدرسه میمانند. راهحل چیست: به ایالتهایی
نگاه کنید که با بالا بردن سنی که دانشآموزان میتوانند مدرسه را ترک کنند در این فرآیند دخالت کردند و سپس ببینید آیا تندرستی افزایش نیافت. اگر تندرستی افزایش یافته است پس میتوان گفت تحصیل باعث افزایش تندرستی میشود.
سایر روشهای برقراری علیت، پیچیدهتر هستند. یک پاسخ که اغلب آزمون شده است اتکا به این اصل است که علت مقدم بر معلوم است. فرض کنید تغییر عرضه پول و سطح قیمت همبستگی دارند و تغییر عرضه پول زودتر از تغییر سطح قیمت باشد. پس، تفسیر سرراست این است که تغییر عرضه پول، علت تورم است.
اما سرراست بودن، همیشه به معنی درست بودن نیست. برای اینکه چنین آزمون زمانبندی معتبر باشد متغیرها باید به درستی تعریف شوند. برای مثال، تئوری اقتصادی به ما میگوید، یا چنین به نظر میرسد که به ما میگوید وقتی فدرال رزرو، نرخ بهره وجوه فدرال (نرخ بهرهای که فدرال رزرو کنترل میکند) را افزایش میدهد سایر نرخهای بهره نیز باید افزایش یابد، اما فرض کنید مشاهده میشود این نرخها پیش از افزایش نرخ بهره وجوه فدرال افزایش مییابند. آیا منظور این است که افزایش آنها باعث شد تا فدرال رزرو نرخ بهره وجوه را افزایش دهد؟ خیر، تبیین محتملتر این است که بازار پیشبینی کرد فدرال رزرو میخواهد چکار کند و نرخهای بهره را درست در آن زمان افزایش داد. متغیری که باید دنبالش بگردیم اقدام فدرال رزرو نیست، بلکه پیشبینی بازار از آن اقدام است.
یا فرض کنید مشاهده میشود عرضه پول زودتر از تولید افزایش نمییابد، بلکه در حدود همان زمان افزایش مییابد. آیا به این معنی است که تولید تاثیر زیادی از سیاست پولی نمیپذیرد؟ دوباره نه لزوما، چون آنچه که میتواند بر تولید تاثیر گذارد سطح (میزان) عرضه پول نیست؛ بلکه نرخ تغییر آن است و نرخ تغییر عرضه پول یک سری متحرک هموار شده دارای قلهها و درههایی است که در سطح آن سری دیده نمیشود. چنین مسالههایی کار را بغرنج میکند.
مشکل دیگر در آزمون ساده زمانبندی این است که حتی اگر قلهها و درههای هر سری آشکارا مرزبندی شوند، معمولا دشوار است که ببینیم آیا یک قله خاص در یک سری باید با قله قبلی یا بعدی در سایر سریها مطابقت یابد. این مشکل وجود نداشت اگر ما میدانستیم مثلا شش ماه زمان میبرد تا یک متغیر بر متغیر دیگر تاثیر گذارد، اما تئوری ما معمولا اینقدر خاص نیست و حتی ممکن است طوری بیان شود که وقفه از موردی به مورد دیگر کاملا تغییر کند. اگر این طور باشد پس در حالی که کاملا درست نیست که بگوییم در مطابقت دادن قلهها و درههای دو سری هر چیزی امکان دارد، چیزهای زیادی بیش از آنچه دوست داریم امکان وقوع دارد. با همه این احوال، یک نگاه ساده به پیامدهای قلهها و درهها احتمالا در غالب اوقات (و به درستی) به عنوان یک تقریب سرانگشتی استفاده میشود
یک واکنش موشکافانه به مساله علیت «آزمون علیت گرنجر» است (که از نام کلایو گرنجر برنده جایزه نوبل گرفته شده است.) در این آزمون، رویداد x، علت رویداد دیگر y دانسته میشود اگر وقوع x بسیار محتمل سازد که متعاقب آن y نیز رخ خواهد داد، (در حالیکه در همان زمان با وقوع y احتمال رخ دادن x وجود نداشته باشد). مشخصتر بگوییم عواملی که رفتار یک متغیر اقتصادی را تعیین میکنند معمولا از فصلی به فصل دیگر (یا حتی سال) تقریبا پایدار میمانند به طوری که رگرس کردن یک متغیر روی مقادیر گذشته آن اغلب اجازه میدهد تا بیشتر رفتار مشاهده آن در فصل بعدی را پیشبینی کنیم. اکنون فرض کنید وقتی مثلا نرخ تورم را روی مقادیر گذشته آن در چند فصل قبل و نیز روی نرخ رشد پول در دوره پیش رگرس میکنید یک ضریب رگرسیون معنیدار و چشمگیر برای نرخ رشد پول به دست میآورید، اما وقتی نرخ رشد پول را روی مقادیر گذشته آن و روی نرخ تورم گذشته رگرس میکنید، ضریب نرخ تورم معنیدار نبوده یا علامت اشتباهی دارد. گرنجر استدلال میکند که نخستین این یافتهها با این فرضیه سازگار است که تغییرات در نرخ رشد پول باعث تغییرات در نرخ تورم میشود در حالی که دومی با این
فرضیه ناسازگار است که تغییر نرخ تورم باعث تغییر در نرخ رشد پول میشود. بنابراین همبستگی مشاهده شده نرخ رشد پول و نرخ تورم باید اینگونه تفسیر شود که اولی باعث دومی میشود، اما اعتبار این تفسیر از علیت هنوز مناقشهبرانگیز است. بهعلاوه، کاربرد موفقیتآمیز آزمون گرنجر مستلزم این است که x با وقفه در یک رگرسیون معنیدار باشد، در حالی که y با وقفه با علامت درست در رگرسیون دیگر معنیدار نیست. اگر اینطور نباشد، پس آزمون گرنجر بیآزمون گرنجر.
آزمونهای علیت گرنجر مثل سایر آزمونهای زمانبندی، با این مشکل مواجهند که بیشتر سری دادههای ما به حد کافی معین و محدود شده زمانی نیستند؛ اگر چه دادههای ساعتی تغییر قیمت سهام را داریم و میتوان دادههای دقیقه به دقیقه از نرخ ارز را به دست آورد، برخی سریها از قبیل تولید صنعتی یا بیکاری فقط ماهانه در دسترس هستند و دادههای GDP فقط فصلی منتشر میشوند؛ بنابراین برخی اوقات ما نمیتوانیم بگوییم کدام متغیر اول حرکت کرد.
سه مشکل دیگر
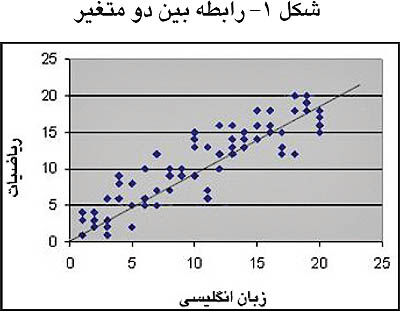
در اینجا سه مشکل کوچکتر؛ اما هنوز مهم را آوردهایم: یکی اینکه با مجذور کردن انحرافات بین مقادیر پیشبینی شده و واقعی y که در محاسبهR۲ صورت میگیرد، اهمیت چند انحراف بزرگ، نسبت به انحرافات کوچک را بزرگ میکند. برای مثال انحراف ۵ و انحراف ۷ دارای میانگین ۶ است همانطور که انحراف ۲ و انحراف ۱۰ میانگین ۶ دارند، اما ریشه دوم میانگین انحراف مجذور شده در مورد اول ۱/۶ و در مورد دوم ۲/۷ است. برای اینکه اثر یک مشاهده پرت را نشان دهیم یک مشاهده پرت را به ۶۳ مشاهده در شکل ۱ اضافه کردیم (گوشه جنوب شرقی)، از ۶۸/۰ به ۴۰/۰ افت میکند. در شکلی دیگر (بر اساس مجموعه متفاوتی از ۳۰ مشاهده) مقدار R۲ = ۴۷/۰، ضریب رگرسیون ۴۶/۰ و مقدار t = ۲/۵ است، اما کل همبستگی از دو مشاهده پرت ناشی میشود. بدون وجود آنها،R۲ به صفر میرسد. کادر ۴ بحث میکند که با متغیرهای پرت چکار کنیم. دوم یک نکته پردردسر وجود دارد: در شکل ۱ هفت مشاهده آخری در گوشه شمال شرقی یک رابطه منفی بین دو متغیر x و y را نشان میدهند به جای رابطه مثبتی که در کل شکل دیده میشود. آیا این نتیجه صرفا به خاطر خطای نمونهگیری است- که اگر فقط ۷ مشاهده داشته باشیم چنین اتفاقی
میافتد- یا اینکه دادهها به ما میگوید رابطه مثبت بین x و y برای مقادیر بسیار بالای x و y برقرار نیست؟ بدون انجام تحقیقات بیشتر چیزی نمیتوان گفت، اما یک چیز روشن است: باید با دقت به نمودار پراکنش نگاه کرد.
سوم، یکی از ناامیدکنندهترین مسائل در علم اقتصاد این است که مدلهایی که دادههای گذشته را به خوبی برازش میکردند اغلب موفق به پیشبینی خوب آینده نمیشوند. دلیل صرفا این نیست که همانطور که بحث شد گذشته آینده نیست، بلکه احتمال دارد خوبی برازش بهدست آمده از دادههای گذشته، نتیجه دادهکاوی باشد.
سرانجام به صورت خودکار فرض نکنید تبیین (یعنی تئوری) ارائه شده توسط معادله رگرسیون با بالاترینR۲ و بهترین مقدار t لزوما بهترین تبیین است. خوبی برازش فقط یکی از چندین معیار در انتخاب بین تئوریها است. تعمیمپذیری، فایدهمندی، امکان ردیابی و مرتبط بودن با سایر تئوریها نیز اهمیت دارد. برای مثال فرض کنید بتوان افزایش دستمزد آتی را با یک معادله رگرسیون که نرخ بیکاری را به عنوان رگرسور استفاده میکند بهتر از رگرسیونی پیشبینی کرد که افزایش دستمزد در هشت فصل قبل را به عنوان رگرسور در نظر میگیرد. قطعا اولی تبیین عمیقتر و معنیدارتری از دومی ارائه میدهد.
۶- نتیجهگیری
بخش زیادی از مطالبی که در این جا آوردیم به ما هشدار میداد که چگونه هنگام خواندن استدلالی بر اساس آمار اقتصادی حواسمان جمع باشد. خوشبختانه چنین خواندن انتقادی معمولا نیازمند هیچ دانش زیادی از اقتصاد و آمار نیست. آنچه نیاز است اقتباس یک گرایش انتقادی به جای سر فرود آوردن خاضعانه در برابر آمارهای تعارف شده است. رسانهها به ما میگویند همبستگی وجود دارد، اما نه فضای نشریه اجازه میدهد و نه رغبتی هست تا چنین «جزئیاتی» مثل متغیرهای کنترل مورد استفاده بحث شوند. در اینباره هیچ کاری نمیتوان انجام داد مگر اینکه زمان کافی برای یافتن منبع اصلی داشته باشیم، اما میتوان پرسید آیا همبستگی پیشنهادی را باید به صورت رابطه علی دید و اگر اینطور است جهت علیت به کدام طرف است.
به طور کلی با توجه به اطلاعات ناقصی که رسانهها درباره جزئیات مطالعات آماری گزارش شده به مخاطبان خود میدهند، معقول است که حداقل مقداری وزن برای عوامل انسانی قائل شویم: این نویسندگان احتمال دارد چه سوگیریهایی داشته باشند، با چه تنبیهی، در صورت وجود، برحسب اعتبار از دست رفته (که برای افراد دانشگاهی و کادر موسسات پژوهشی میتواند بسیار گران تمام شود) مواجه میشوند اگر خطا کنند؟ آیا هیچ عبارت گمراهکننده یا سهلانگارانهای از این نویسندگان در گذشته دیدهاید؟ آیا این بررسی در نشریهای منتشر شده است که اهل فن به آن ارجاع میدهند؟
برخی اوقات تنها راهحل، تایید نادانی و برخورد محتاطانه با اطلاعات در دسترس است. نه اینکه آن را صرفا به عنوان یک «واقعیت» ببینیم چون که به شکل یک «عدد» درآمده است. این عبارت که کسری بودجه دولت طی پنج سال آینده ۳/۳۰۱ میلیارد دلار خواهد شد به همان اندازهای «غیر علمی» است که بگوییم کسری بودجه زیاد خواهد بود.
برای اینکه چنین نگاه توام با شک و تردیدی پیدا کنید در فصول گذشته دامهای بالقوه بسیاری را پوشش دادیم که احتمال دارد برخی خوانندگان با خود فکر کنند در علم اقتصاد، نتایج آماری را هرگز نباید جدی گرفت. این فکر اشتباهی است. جایگزین اتکا کردن به آمار اقتصادی، کور شدن اشتهای علمی است: اتکا به تاکیدات صرف، حکایات، درسهایی از یک یا چند رویداد مهم نادر یا به تئوریسازی آزمون نشده.
بهعلاوه، آمارهای مشکوک در علوم طبیعی نیز ناشناخته نیستند و در عین حال این علوم پیشرفتهای خیرهکنندهای کردهاند. همچنین همان طور که در فصل بعدی با مثالهایی مشخص نشان خواهیم داد، به رغم مشکلات بیشماری که در این فصل و فصول قبلی بحث شد، تحلیل اقتصادسنجی قابلیت ارائه دانشهای ارزشمندی به ما دارد. سرانجام بحث انتقادی استدلال شفاهی و حقههای خطابههای آن نیز میتواند این تاثیر را بر جا گذارد که آنها را هم نباید جدی گرفت. «هشدار سخنران یا شنونده باید عاقل باشد» در هر جایی و نه فقط در کارهای اقتصاد سنجی کاربرد دارد، اما آنچه این عبارت معنی میدهد «خواننده آگاه باشد» است نه اینکه «خواندن را متوقف کند.»
کادر۱- ضریب تعیین و ضریب همبستگی
برای محاسبهR۲، دو حدس درباره مقدار هر کدام از yها مقایسه میشود. یکی حدسی که شما میزنید اگر اصلا هیچ شناختی درباره رابطه x و y نداشتید و دیگری حدسی است که شما میزنید وقتی معادله رگرسیونی دارید که x را به y در دسترس ارتباط میدهد و مقادیر هر کدام از xها را میدانید. برای مثال، اگر میخواهید مخارج مصرف سالانه یک خانواده خاص را حدس بزنید که هیچ چیز درباره آن نمیدانید، بهترین کاری که میتوانید انجام دهید استفاده از میانگین مخارجی همه خانوادهها است. اکنون فرض میکنیم درآمد خانواده به شما گفته شده است و نیز معادله رگرسیون را دارید:
مخارج مصرفی = (۰۰۰/۲۰) + (۸/۰) درآمد است. سپس شما با این اطلاعات میتوانید مصرف خانواده را تخمین بزنید.
در این مورد و همچنین موردی که معادله رگرسیون را در اختیار نداریم و فقط میانگین مخارج مصرفی همه خانوادهها را استفاده میکنیم، تخمین به دست آمده مقداری خطا خواهد داشت و اندازه نسبی خطا در این دو مورد به ما میگوید که معادله رگرسیون چقدر توانسته است تخمین ما را بهبود ببخشد. بنابراین میتوان از نسبتی استفاده کرد که در صورت آن، میزان خطا باشد وقتی معادله را داریم و در مخرج آن، میزان خطا باشد وقتی معادله را نداریم. اگر معادله یک برازش کامل باشد خطای ما وقتی معادله را استفاده میکنیم صفر خواهد بود و نسبت آنها ۱ خواهد شد، اما اینکه بخواهیم از نسبتی استفاده کنیم که خوبی برازش معادله رگرسیون را با پایین بودن آن به نشانه بهتر بودن معادله نشان دهد چندان جالب به نظر نمیرسد پس یک کلک میزنیم که سنجه همبستگی را نه با نسبت بالا بلکه با ۱ منهای آن نسبت بیان میکنیم. پس بیدرنگ میتوان نتیجه گرفت: اکنون همبستگی بهتر زمانی است که سنجه همبستگی بالاتر باشد. به یک گام بیشتر نیاز داریم. به دلایل فنی، بهتر است خطاهای میانگین که با استفاده و بدون استفاده از معادله به دست آوردیم را مقایسه نکنیم بلکه در عوض میانگین مجذور خطاها را
مقایسه کنیم که این همان R۲ است.
کادر ۲- اندازهگیری روندها
یکی از کاربردهای رایج رگرسیون، یافتن روند یک سری از قبیل GDP است. تمام کاری که باید بکنید واگذاری اعداد پشت سرهم (مثلا ۱، ۲، ۳، .... n) به هر کدام از مشاهدات پیدرپی (مثلا سالانه) و سپس رگرس کردن متغیر y روی این اعداد است. اندازهگیری روندها نه فقط برای پیشبینی مفید است، بلکه همچنین برای نشان دادن اینکه چگونه تغییر متغیر طی یک دوره خاص را با تغییر معمولی آن مقایسه کنیم. برای مثال معنیدار ساختن یک گزارش به این شیوه آسانتر است که «اشتغال در ماه گذشته، اندکی بیش از روند خود رشد کرد» تا اینکه گزارش را چنین تفسیر کنیم که «میزان اشتغال ۱۱۰ هزار تا رشد کرد». خواننده نمیداند آیا ۱۱۰ هزار شغل، افزایش «بزرگ» یا «کوچکی» است.
روش دیگر شنیدن صدای آرام اما استوار تغییر بلندمدت از طریق حرکات پیاپی کوتاه مدت، برازش یک میانگین متحرک روی دادهها است. ایده اساسی این است که ما فهم بهتری در مورد برخی دادهها، مثلا قیمت سهام به دست میآوریم اگر صرفا به مقدار جاری آنها نگاه نکنیم بلکه به مقدار میانگین آنها طی یک مدت زمان نگاه کنیم. بنابراین یک دوره با طول زمانی معین (اغلب به دلخواه خود) مثلا پنج سال انتخاب کنید و میانگین را برای این پنج سال به دست آورید و این میانگین را در سال وسط دوره پنج ساله نقطهگذاری کنید. سپس سال اول را حذف کرده و یک سال به انتها میافزاییم و این را به صورت نقطهای برای سال بعد میگذاریم و الی آخر. چنین میانگین متحرکی بیشتر نوسانات دوره به دوره را حذف کرده، اما به خشکی روند خط راست نیست.
اینجا دو هشدار درباره روندها میدهیم. نخست، ارزش ضریب روند را برخی اوقات میتوان با انتخاب تاریخ شروع یا پایان خاص دستکاری کرد. اگر با سالی شروع کنیم که متغیر به نحو غیرعادی پایین بوده است نرخ رشد سریعتری به دست میآوریم نسبت به حالتی که یک سال با بالا بودن غیرعادی متغیر را انتخاب کنیم. دوم اینکه روند، سرنوشت محتوم نیست. به هشدار پیشگویان بدبین یا وعدههای شتابزده افراد خیالپرداز که روندهای جاری را برای آینده پیشبینی میکنند اعتنایی نکنید. اگر بازار سهام در سه سال گذشته هر سال ۳۰ درصد رشد کرده است قطعا برای ده سال آینده ادامه نخواهد یافت.
در اینباره متاسفم.
بدبختانه، در حالی که پیشبینی آنچه اتفاق خواهد افتاد یا تحلیل عوامل زیربنایی آن کاری مشکل است، پیشبینی یک روند آسان بوده و اغلب به نتیجهگیری شگرف و بنابراین با ارزشی منجر میشود، به خصوص اگر خوانندگان این شرط را فراموش کنند: «اگر روندهای جاری ادامه یابد.» واکنش مناسب به شیفتگان روند این است که بگوییم بسیار زودتر از آن زمانی که پیشبینیها به آزمون گذاشته شود همه ما مردهایم یا به وسیله یک گربه غولآسا بلعیده شدهایم. یک بچه گربه در همسایگی ما هست که جثهاش اکنون دو برابر هفته قبل شده است. این روند را برای پنج سال آینده پیشبینی کنید.
کادر۳- استفاده از رگرسیون برای ردیابی تبعیض جنسیت
یک شیوه استاندارد برای ردیابی تبعیض شغلی، استفاده از تحلیل رگرسیون برای تعیین این است که آیا نژاد یا جنسیت شخص، به تبیین حقوق وی نسبت به حقوق سایر کارکنان با شایستگیهای مشابه کمک میکند. بیایید ببینیم چگونه آزمون تعیین تبعیض علیه اساتید زن را انجام میدهیم. نخست درباره همه متغیرهایی که حقوق اساتید را تعیین میکنند فکر میکنیم. سپس معادلهای مثل زیر را مینویسیم:
y= a +bx۱ +cx۲ +dx۳ +ex۴ +fx۵ +gx۶ +hx۷
در اینجا y حقوق هر پروفسور در نمونه، a عدد ثابت، X۱ سنجه کیفیت دانشگاهی است که استاد مدرک دکتری خود را گرفته است، X۲تعداد سالهای پس از گرفتن مدرک دکتری است، X۳ رشته تحصیلی استاد، X۴ ارزیابیهای عملکرد تدریس وی، X۵ شاخص نشریات، X۶جنسیت و X۷ همه متغیرهای دیگری است که باید شامل میشد؛ اما نادیده گرفته شده است چون که شناخته شده نیستند یا قابل اندازهگیری نیستند؛ معنیدار بودن آماری و محتوایی g خواهد گفت که آیا تبعیض جنسی وجود دارد و چقدر بزرگ است.
هنگام برازش این معادله به دادهها، متغیر اسرارآمیزX۷ البته باید حذف شود. اگر و فقط اگر همبستگی مثبت یا منفی با X۶ متغیر جنسیت نداشته باشد یا اگرX۷ اثر اندکی بر حقوق اساتید داشته باشد، g یک تخمین بدون سوگیری از دامنه تبعیض جنسیتی خواهد بود. چنین برمیآید که این مطالعات قابلیت اتکای بالایی ندارند؛ اما آیا روشهای بهتری برای پاسخ دادن به این پرسش وجود دارد؟
کادر۴- با مشاهدات پرت چکار کنیم؟
یک موضع افراطی این است که چون مشاهدات پرت با بقیه دادهها همخوانی ندارند باید اشتباهی در رابطه با آنها شده باشد؛ بنابراین میتوان آنها را بدون حتی گفتن به خواننده کنار گذاشت. برای اینکه دفاع قوی از این ادعا بشود، فرض کنید مجموعه دادههای ساعتی کارگران منسوجات را داریم و در جلوی یکی از مشاهدات عدد ۱ میلیون دلار نوشته شده است، اما بیشتر مشاهدات پرت ظاهرا بیمصرف نیستند و کنار گذاشتن مشاهدات پرت میتواند به کنار گذاشتن مشاهداتی تنزل نماید که از فرضیه پژوهشگر پشتیبانی نمیکنند. اگر کمترین تردید درباره توجیه برای کنار گذاشتن یک مشاهده پرت داریم، به خوانندگان باید گفته شود که آن را کنار گذاشتیم و چرا.
موضع افراطی دیگر این است که بگوییم «خب، این آن چیزی است که دادهها نشان میدهند و همین که هست، اما این کار غیرواقعبینانه است. وقتی یک مشاهده پرت دارید به درستی احساس میشود که باید آن را بررسی کرد. از این گذشته احتمال دارد که آن به خاطر خطای در ثبت اعداد باشد. یا احتمال دارد که عددی واقعی اما یک مورد خاص باشد. برای مثال اگر متغیر وابسته ما، تعداد سفرهای هوایی باشد، مشاهده پرت مثلا بیانگر اعتصاب در یک شرکت مهم هواپیمایی است. اگر بتوان دفاع معقول کرد که مشاهده پرت مورد خاصی است، پس میتوان نتایج رگرسیون را با و بدون آن گزارش داد. تکنیکهای ریاضی برای تشخیص مشاهدات پرت وجود دارد، اما حتی با اینحال اینکه کجا خط را بکشیم گاهی اوقات یک مساله پیچیده است. چنین وابستهبودنی به قضاوت شخصی، عمل «غیرعلمی» نیست.